オープンウェイトとは?|オープンソースとの違いを徹底解説!


「オープンウェイトとオープンソースは、何が違うの?」
「オープンウェイトモデルには、どんなものがあるか知りたい」
「オープンウェイトモデルを、自社の業務で使ってもよいのか気になる」
「オープンウェイト(Open Weight)」とは、学習済みのAIモデルを公開し、誰でも手元で使えるようにすることを指します。使える範囲は、モデルごとのライセンスで決まります。
一方、オープンソースはソースコードを公開し、自由な再配布や改変を許可する概念です。
ChatGPTをはじめとする今のAIのモデルは、プログラムを書き足すのではなく、学習させるデータを増やすことで性能を上げられます。
そのため、モデルを作ったソースコードを公開しなくても、モデルと、その「重み」と呼ばれるパラメータを公開するだけで価値が出るようになってきました。
本記事では、オープンウェイトとオープンソースの違いを、公開対象・利用目的・ライセンスの3つの点から解説します。あわせて、主なオープンウェイトモデルと、業務で使うときに確かめることも紹介します。
【本記事でわかること】
オープンウェイトとオープンソースの意味
オープンウェイトとオープンソースの違い
主なオープンウェイトモデルとライセンス
オープンウェイトの利点と課題
オープンウェイトモデルを業務で使うときに確かめること
オープンウェイトとは
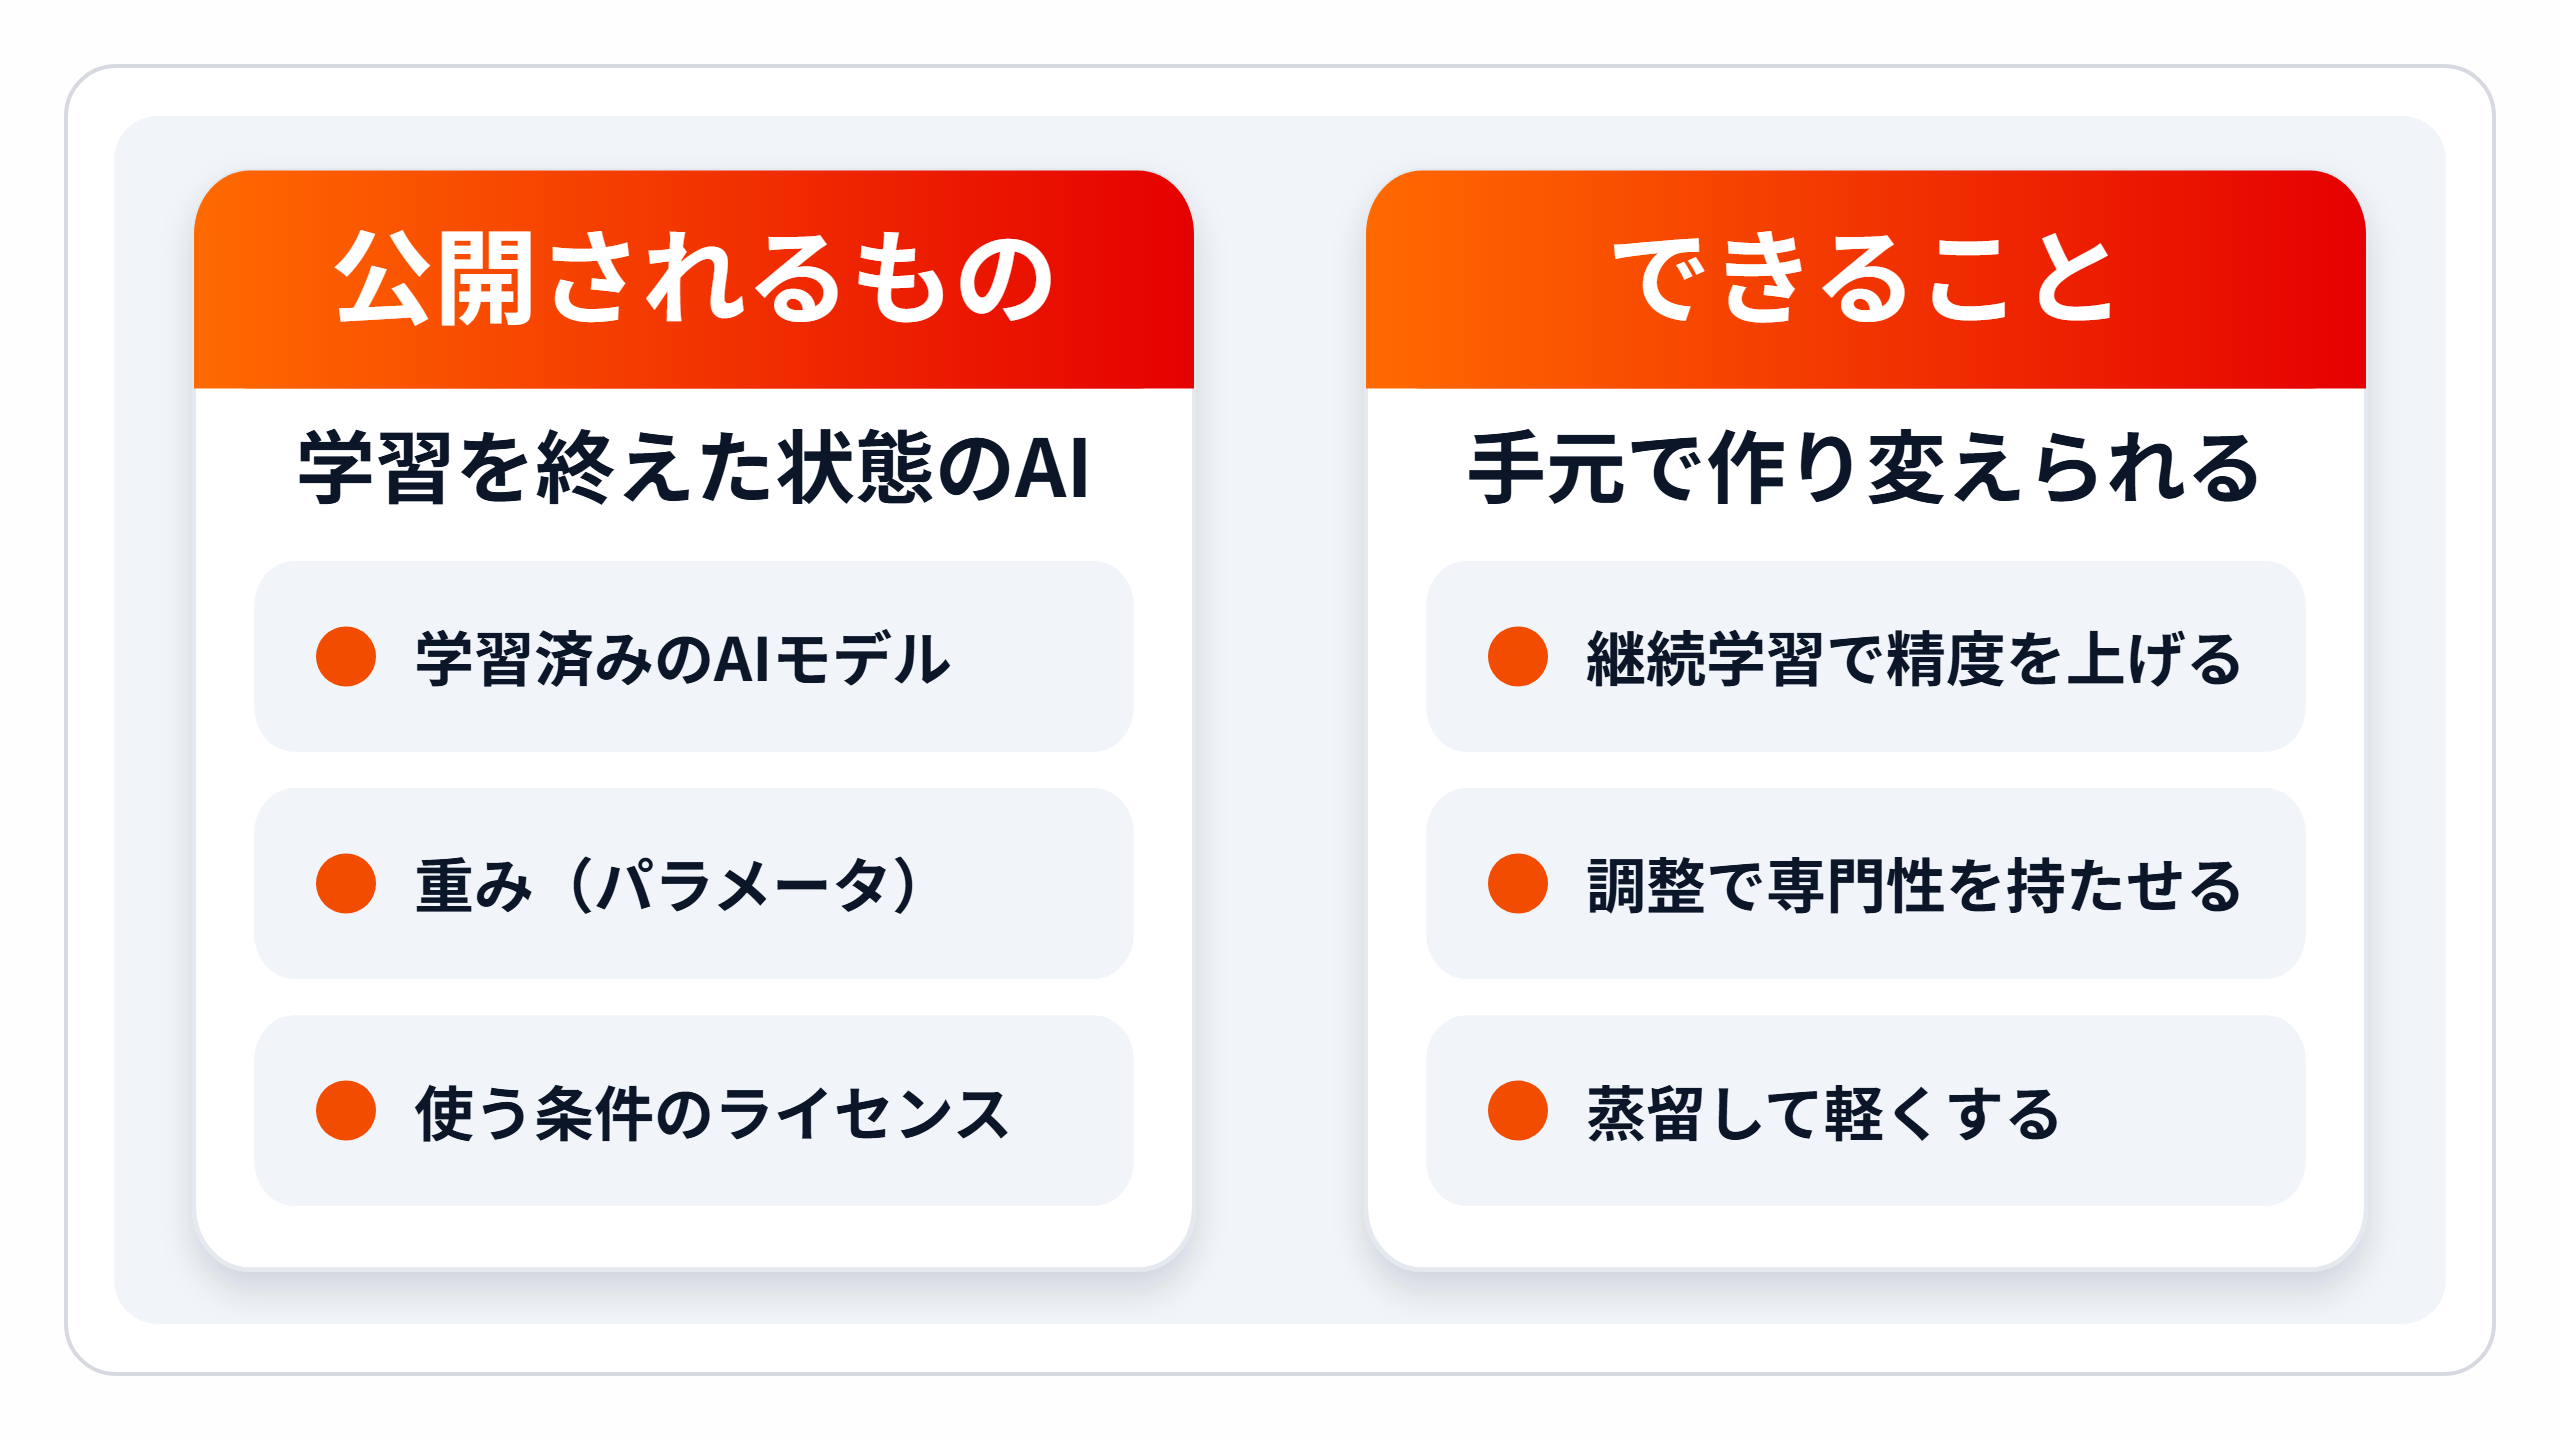
オープンウェイトとは、学習済みのAIモデルを公開し、誰でも手元で利用・応用できるようにすることです。「ウェイト」は英語で「重み」のことで、AIモデルが学習で身につけた数値(パラメータ)を指します。オープンウェイトの特徴は以下の通りです。
学習済みモデルの公開:訓練に膨大な時間とコストがかかるAIモデルを、学習済みの状態で公開します。
ライセンスで決まる利用条件:商用利用を含む幅広い用途で使えるモデルが多くありますが、条件はモデルごとに異なります。
コミュニティによる発展:公開されたモデルを、ほかの開発者や研究者が改良したり、応用したりできます。
オープンウェイトモデルは、重みまで公開されているので、手元で作り変えられます。
追加のデータで学習を続ける「継続学習」で精度を上げたり、目的に合わせて調整する「ファインチューニング」で専門性を持たせたりできます。大きなモデルの知識を小さなモデルに移す「蒸留」で、軽いモデルを作ることもできます。
主なオープンウェイトモデル(2026年11月時点)
いま公開されている主なオープンウェイトモデルを、提供元とライセンスで整理しました。同じオープンウェイトでも、ライセンスによって使える範囲が変わります。
モデル | 提供元 | ライセンス | 主な条件 |
|---|---|---|---|
gpt-oss | OpenAI | Apache 2.0 | 商用利用・改変・再配布ができる |
Gemma 4 | Apache 2.0 | 商用利用・改変・再配布ができる | |
Muse Spark Open | Meta | Muse Model License | 商用利用・改変ができる。「Built with Muse Spark Open」の表示が要るほか、AIモデルを外部に提供する事業で年間売上が2,000万ドルを超える場合は、Metaとの別の契約が必要 |
DeepSeek-V4 | DeepSeek | MIT License | 商用利用・改変・再配布ができる |
出典:Hugging Face「openai/gpt-oss-120b」
出典:Google Open Source Blog「Gemma 4: Expanding the Gemmaverse with Apache 2.0」
出典:Hugging Face「meta-models/Muse-Spark-Open-816B-A42B」
出典:Hugging Face「deepseek-ai/DeepSeek-V4.1-Flash」
Apache 2.0やMIT Licenseは、オープンソースのソフトウェアで広く使われるライセンスです。これらのライセンスで公開されるモデルがある一方で、提供元が独自に条件を定めたライセンスで公開されるモデルもあります。
業務で使う前に、それぞれのモデルのライセンスを確かめておきましょう。
関連記事:Metaの最新AI・Llama(ラマ)3が注目される理由とは?日本語での体験方法から企業での活用事例まで徹底解説
オープンソースとは
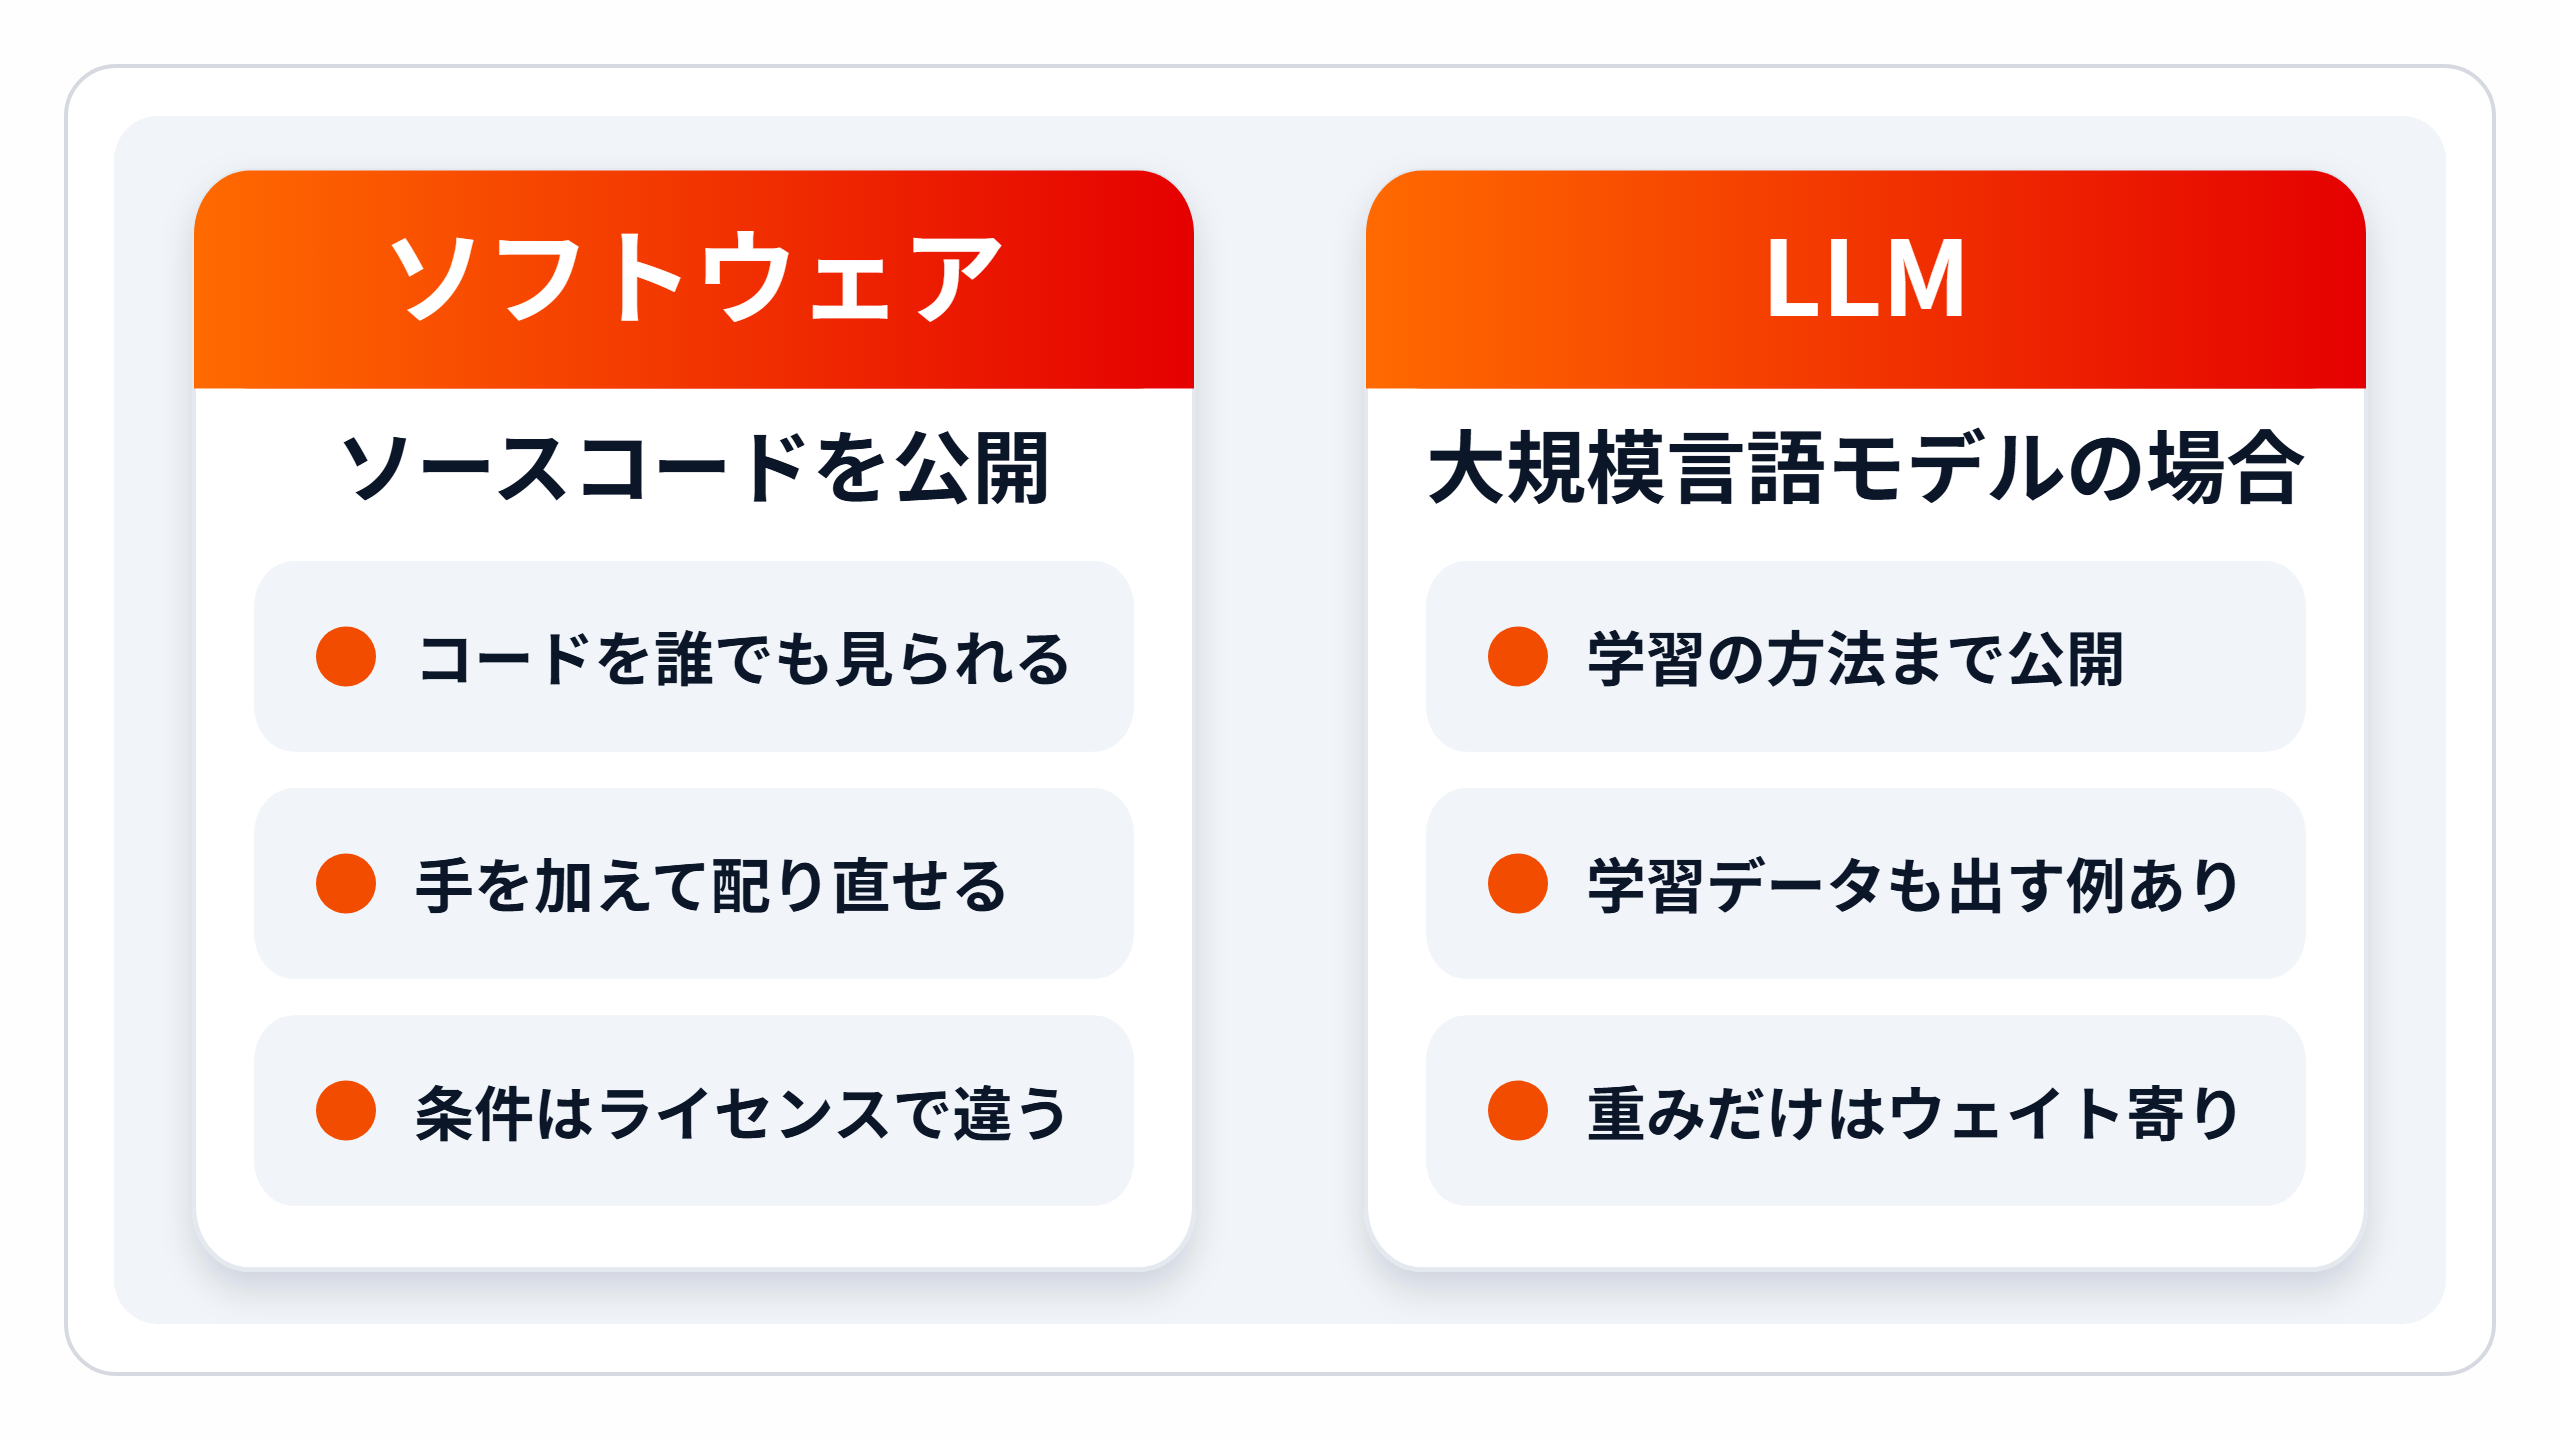
オープンソース(Open Source)とは、ソフトウェアのソースコードを公開し、誰もが自由に利用、改変、再配布できるようにすることです。オープンソースの特徴は以下の通りです。
ソースコードの公開:ソフトウェアのソースコードを公開し、誰もが自由に閲覧、利用できるようにします。
自由な再配布:オープンソースのソフトウェアは、通常自由に再配布することが許可されています。
派生物の作成:オープンソースのソフトウェアは、誰もが自由に改変し、派生物を作成できます。
基本的にはこのような特徴がありますが、作者名やライセンスを表示しなければならないか、改変後のソースも公開しなければならないかなどは、ライセンスによって変わります。
LLM(大規模言語モデル)をオープンソースで公開する場合は、学習のさせ方や細かいテクニック、さらには学習に使ったデータまで公開される例もあります。
オープンソースのライセンスで公開されたLLMでも、公開の形がオープンウェイトに近いものがあります。
たとえば、xAIが2024年3月にApache 2.0で公開したGrok-1は、モデルの重みとネットワークの構造が公開されましたが、学習に使ったデータは含まれていません。
出典:xAI「Open Release of Grok-1」
オープンウェイトとオープンソースの違い
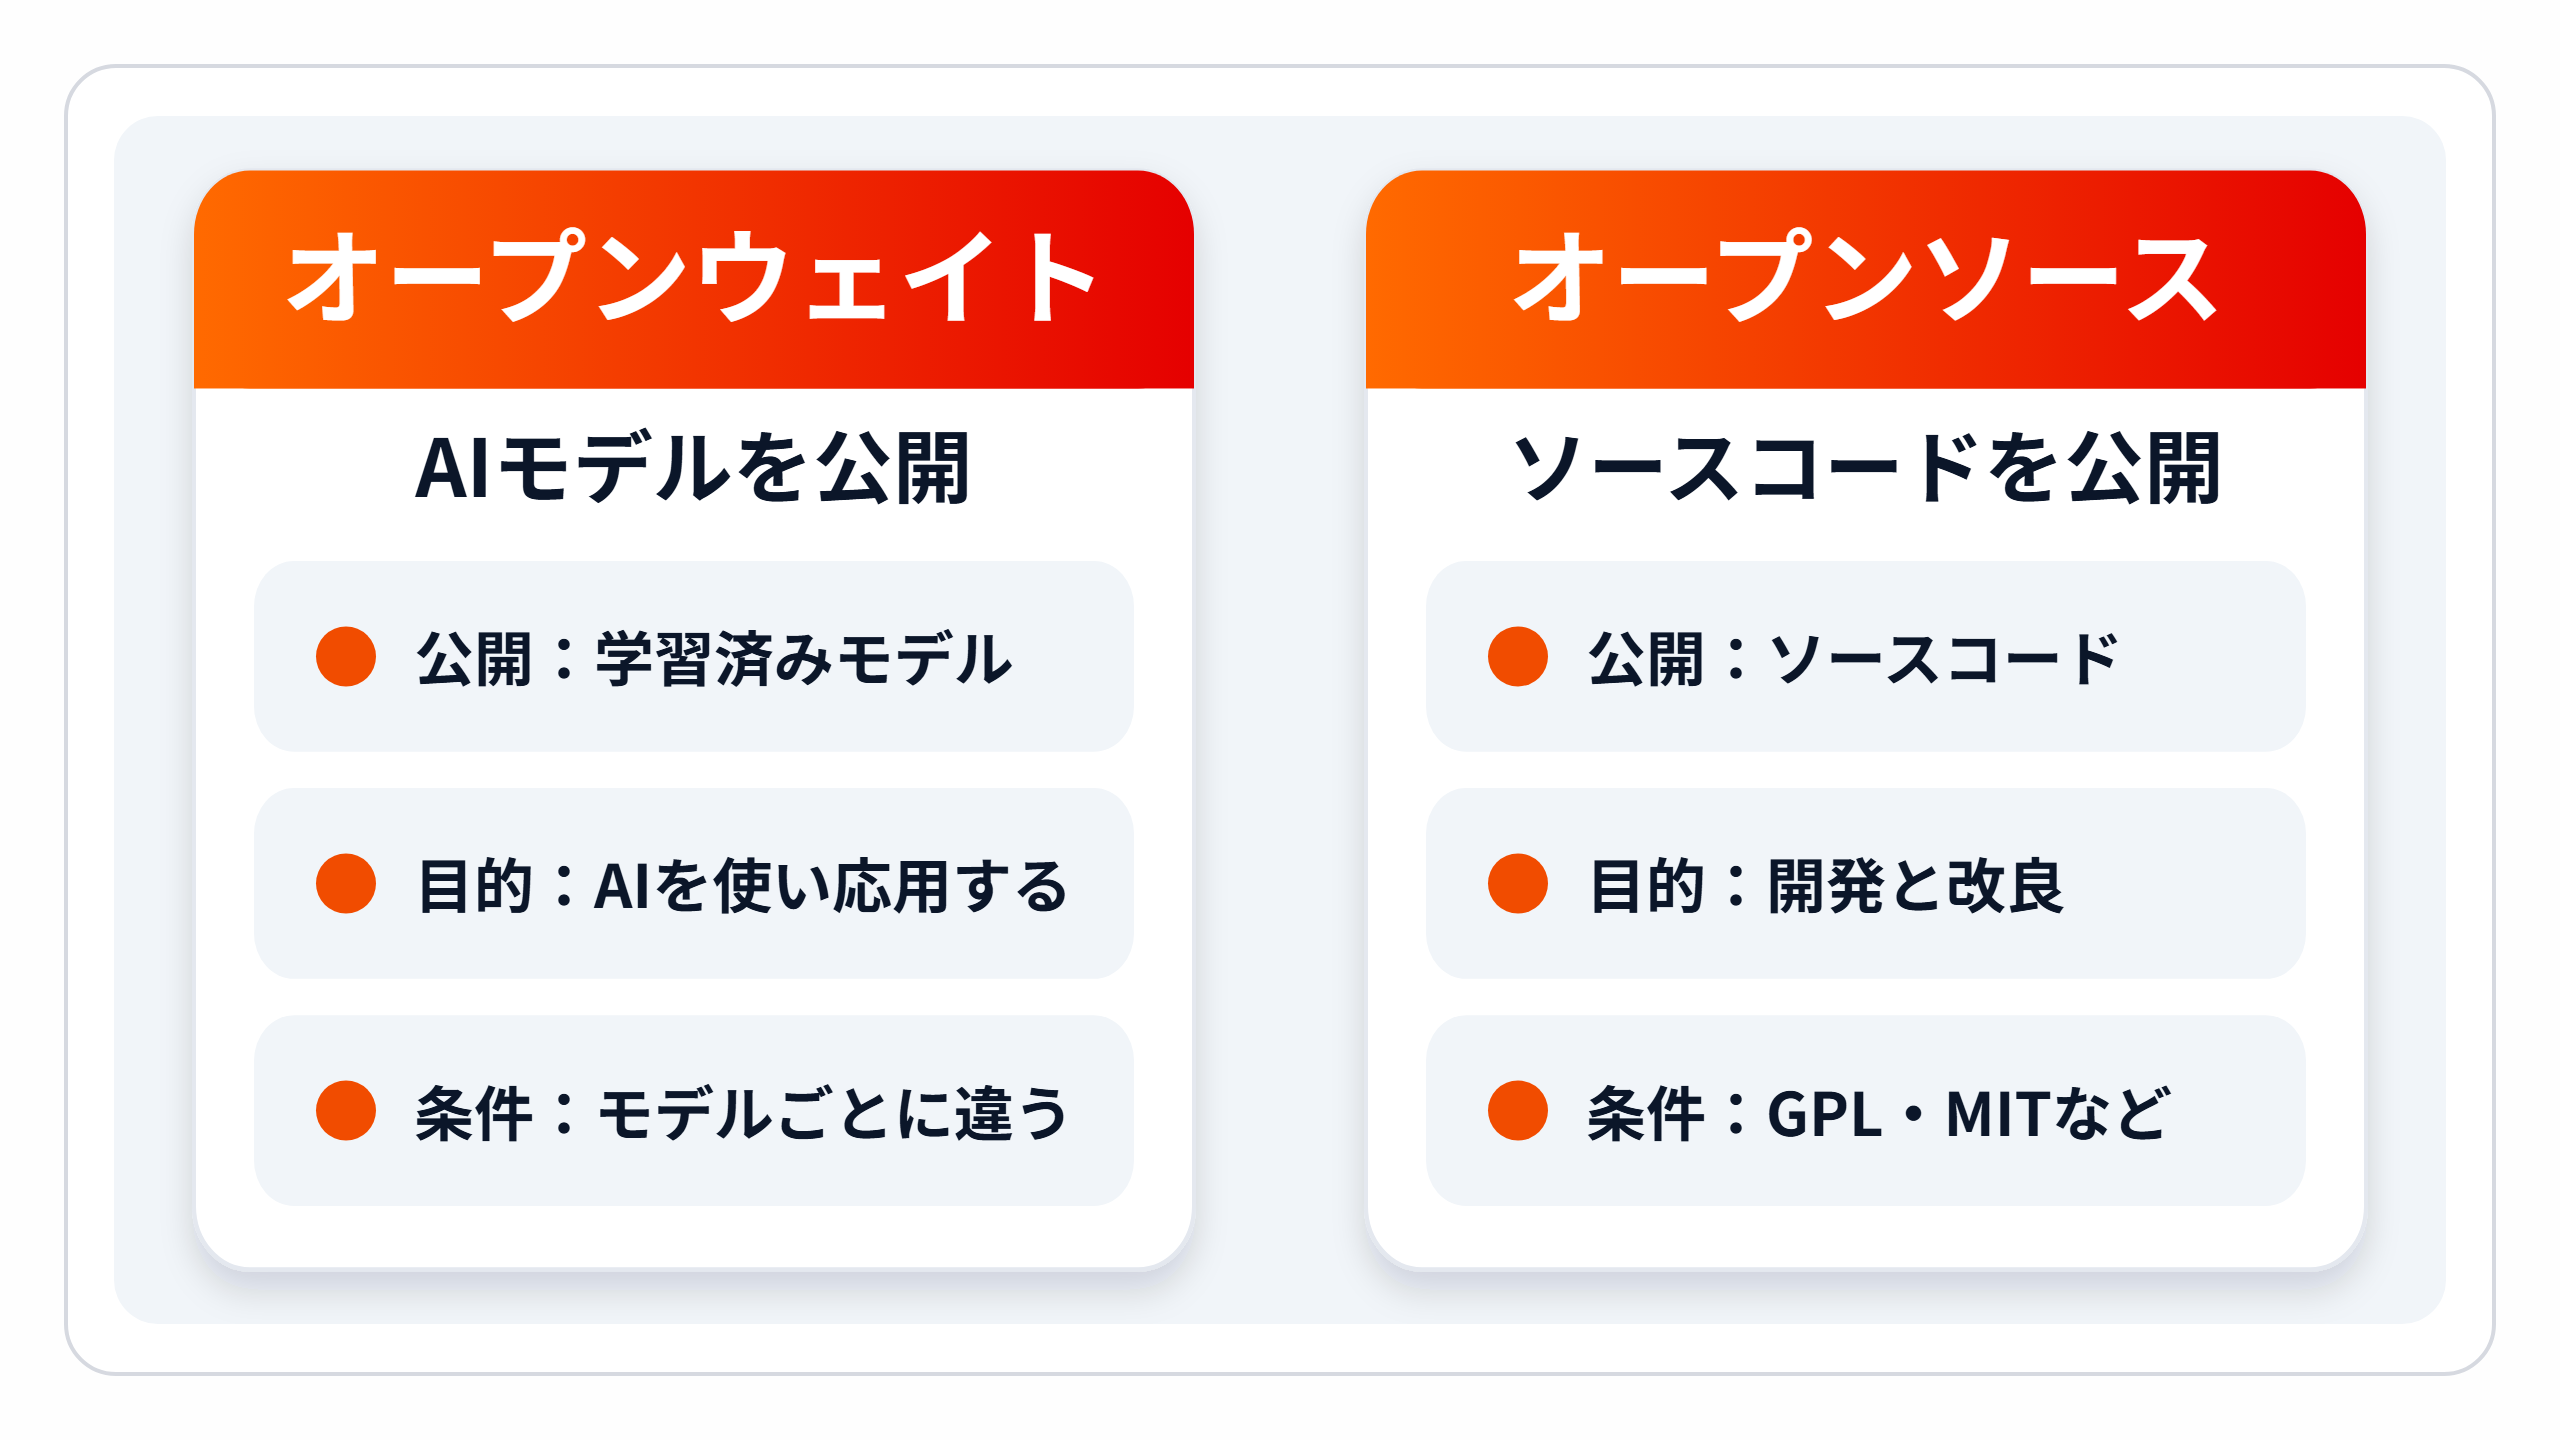
オープンウェイトとオープンソースの主な違いは、公開対象・利用目的・ライセンスの3つです。
公開対象の違い
オープンウェイト:学習済みのAIモデルを公開します。
オープンソース:ソフトウェアのソースコードを公開します。
利用目的の違い
オープンウェイト:AIモデルを利用し、応用することが主な目的です。
オープンソース:ソフトウェアの開発と改良が主な目的です。
ライセンスの違い
オープンウェイト:商用利用を許可するライセンスが多い一方で、提供元が独自の条件を定めたライセンスもあります。
オープンソース:GPL、MIT、Apache 2.0など様々なライセンスがあり、改変後のソースの公開が求められるかなどの条件が違います。
オープンウェイトの利点と課題
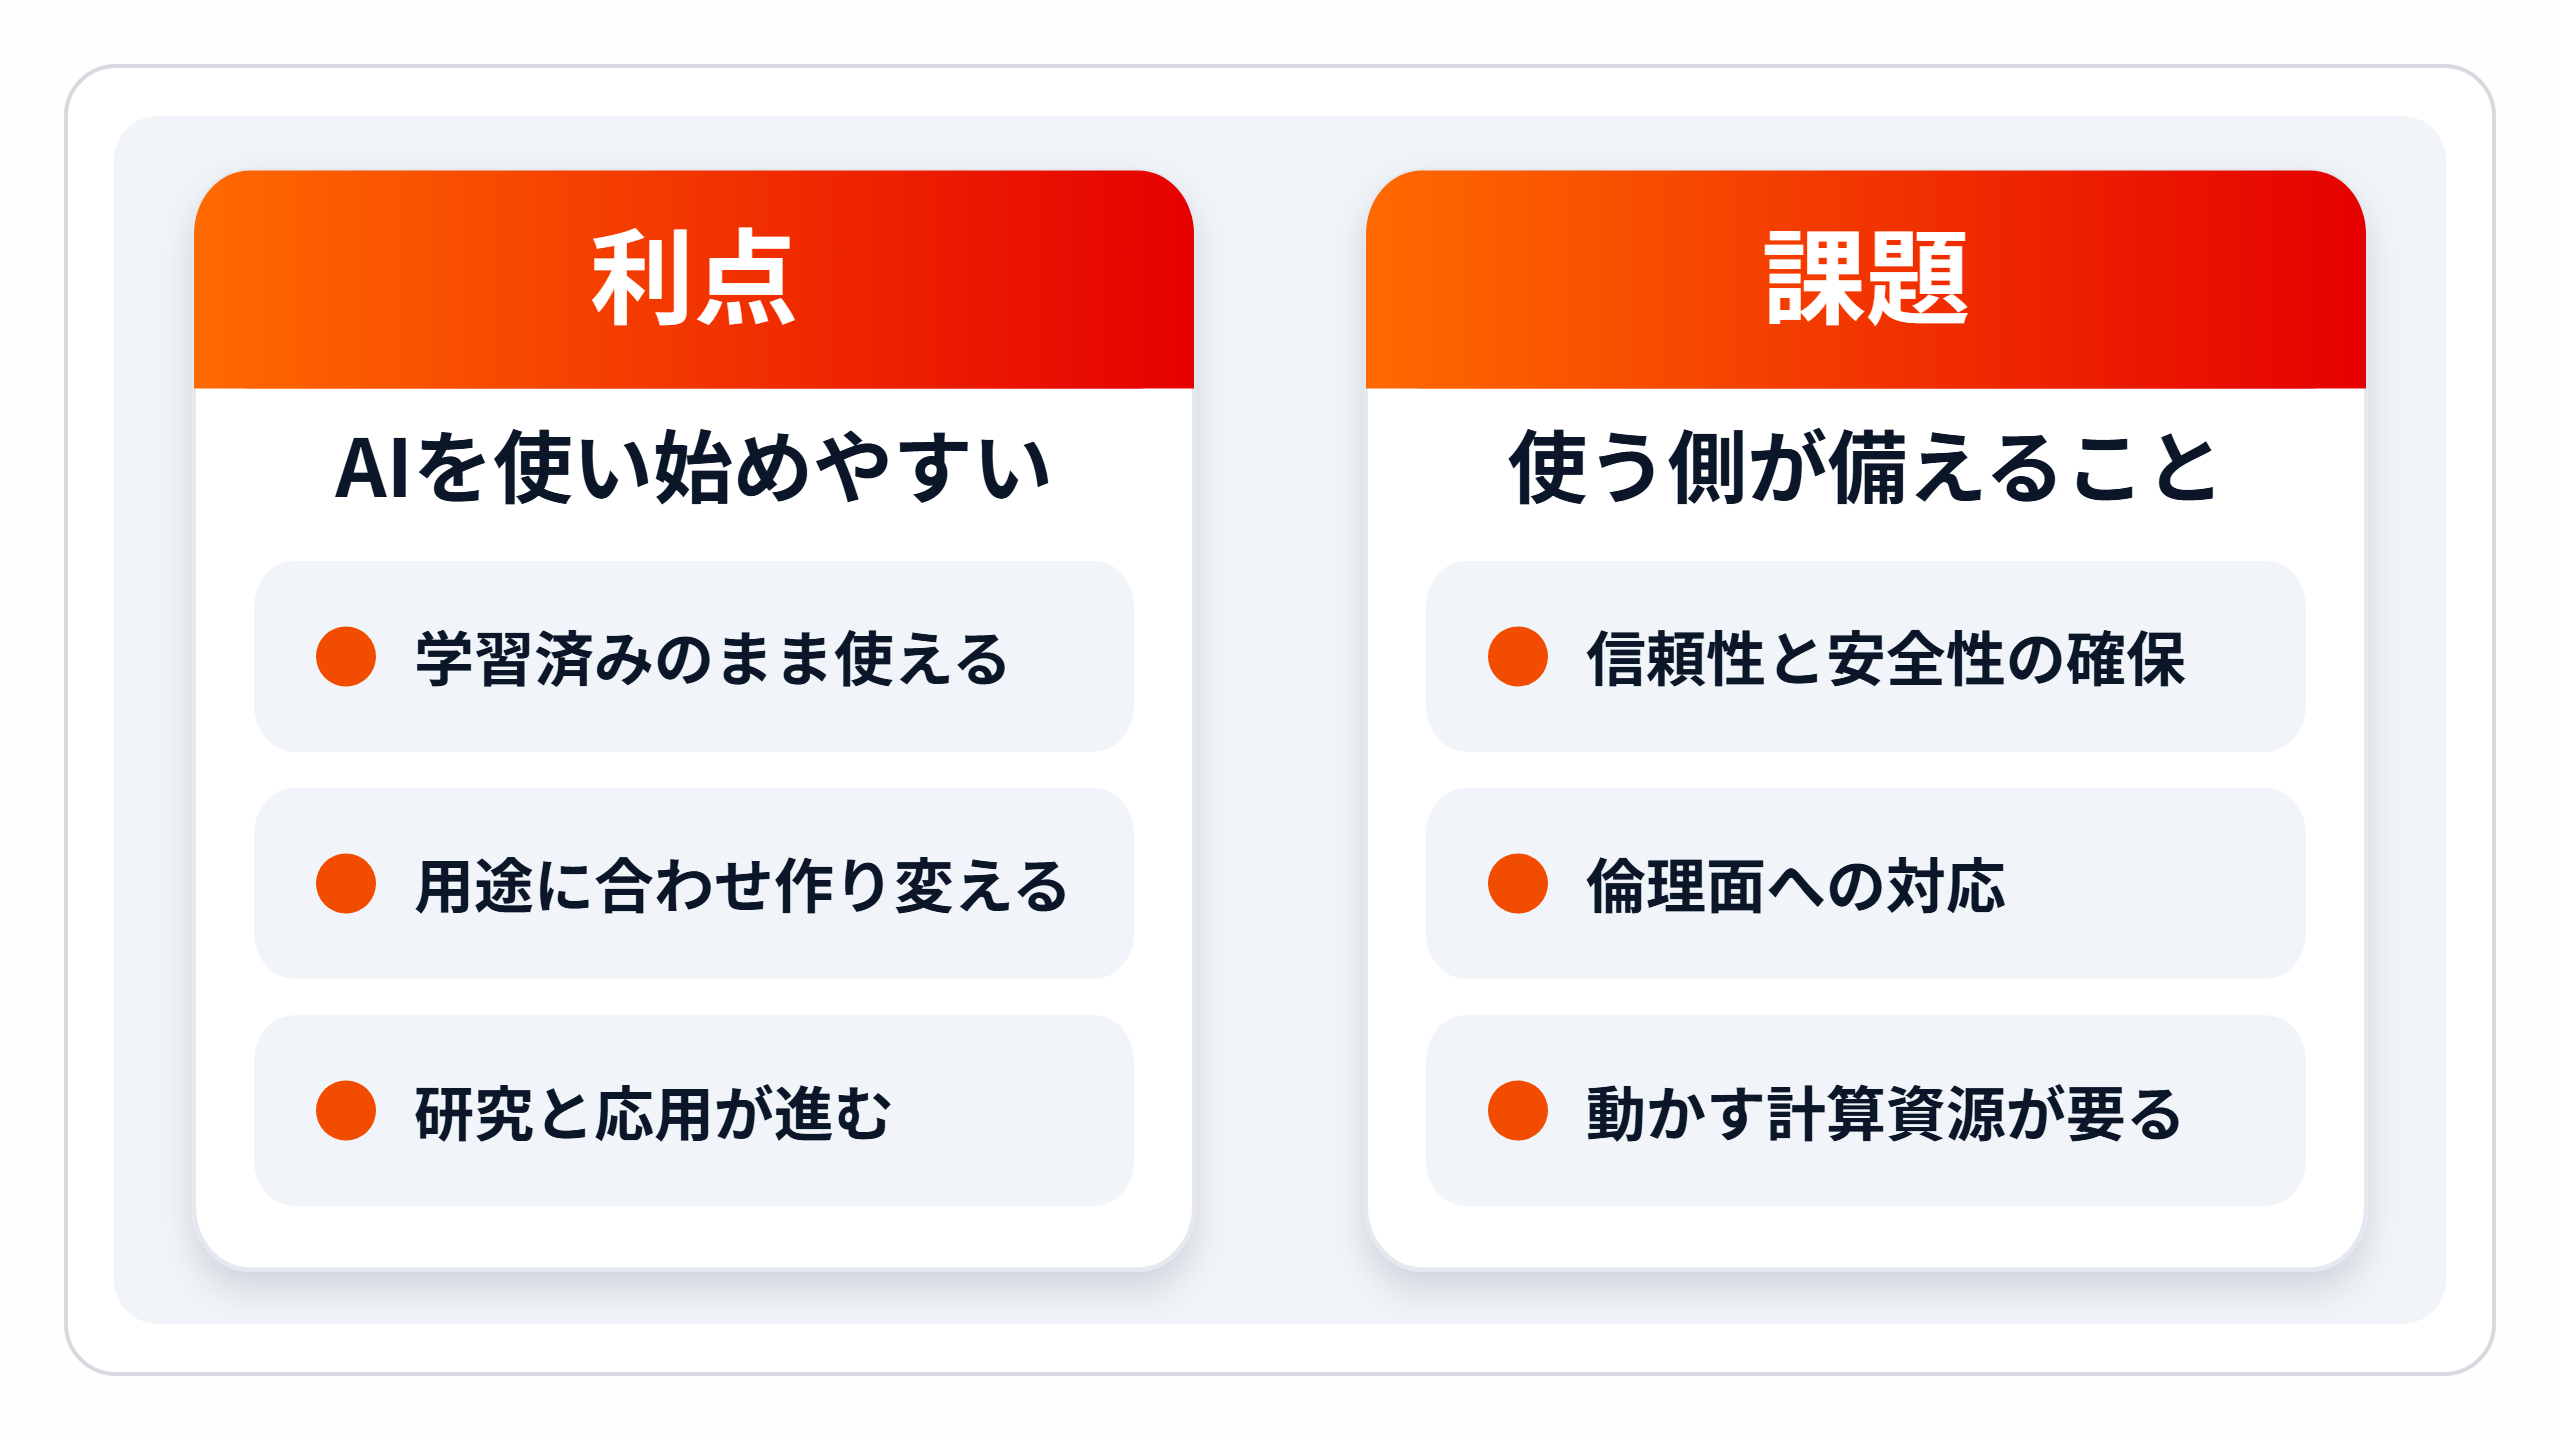
オープンウェイトには、以下のような利点と課題があります。
利点
AIモデルの利用しやすさ:学習済みのモデルを使えるため、一から学習させる時間と費用をかけずにAIを使い始められます。
用途に合わせた作り変え:ファインチューニングや蒸留で、専門性を持たせたり軽量にしたりできます。
研究と応用の広がり:公開されたモデルを多くの人が試せるため、ほかの開発者や研究者による改良や応用が進みやすくなります。
課題
モデルの信頼性と安全性:公開されたモデルの答えの正しさや安全性は、使う側が確かめる必要があります。
倫理的な問題への対応:AIの利用に伴う倫理的な問題に、使う側が対応することが求められます。
動かすための計算資源:自社の環境で動かすには、モデルの大きさに合ったGPUなどの計算資源が要ります。
オープンウェイトモデルを業務で使うときに確かめること
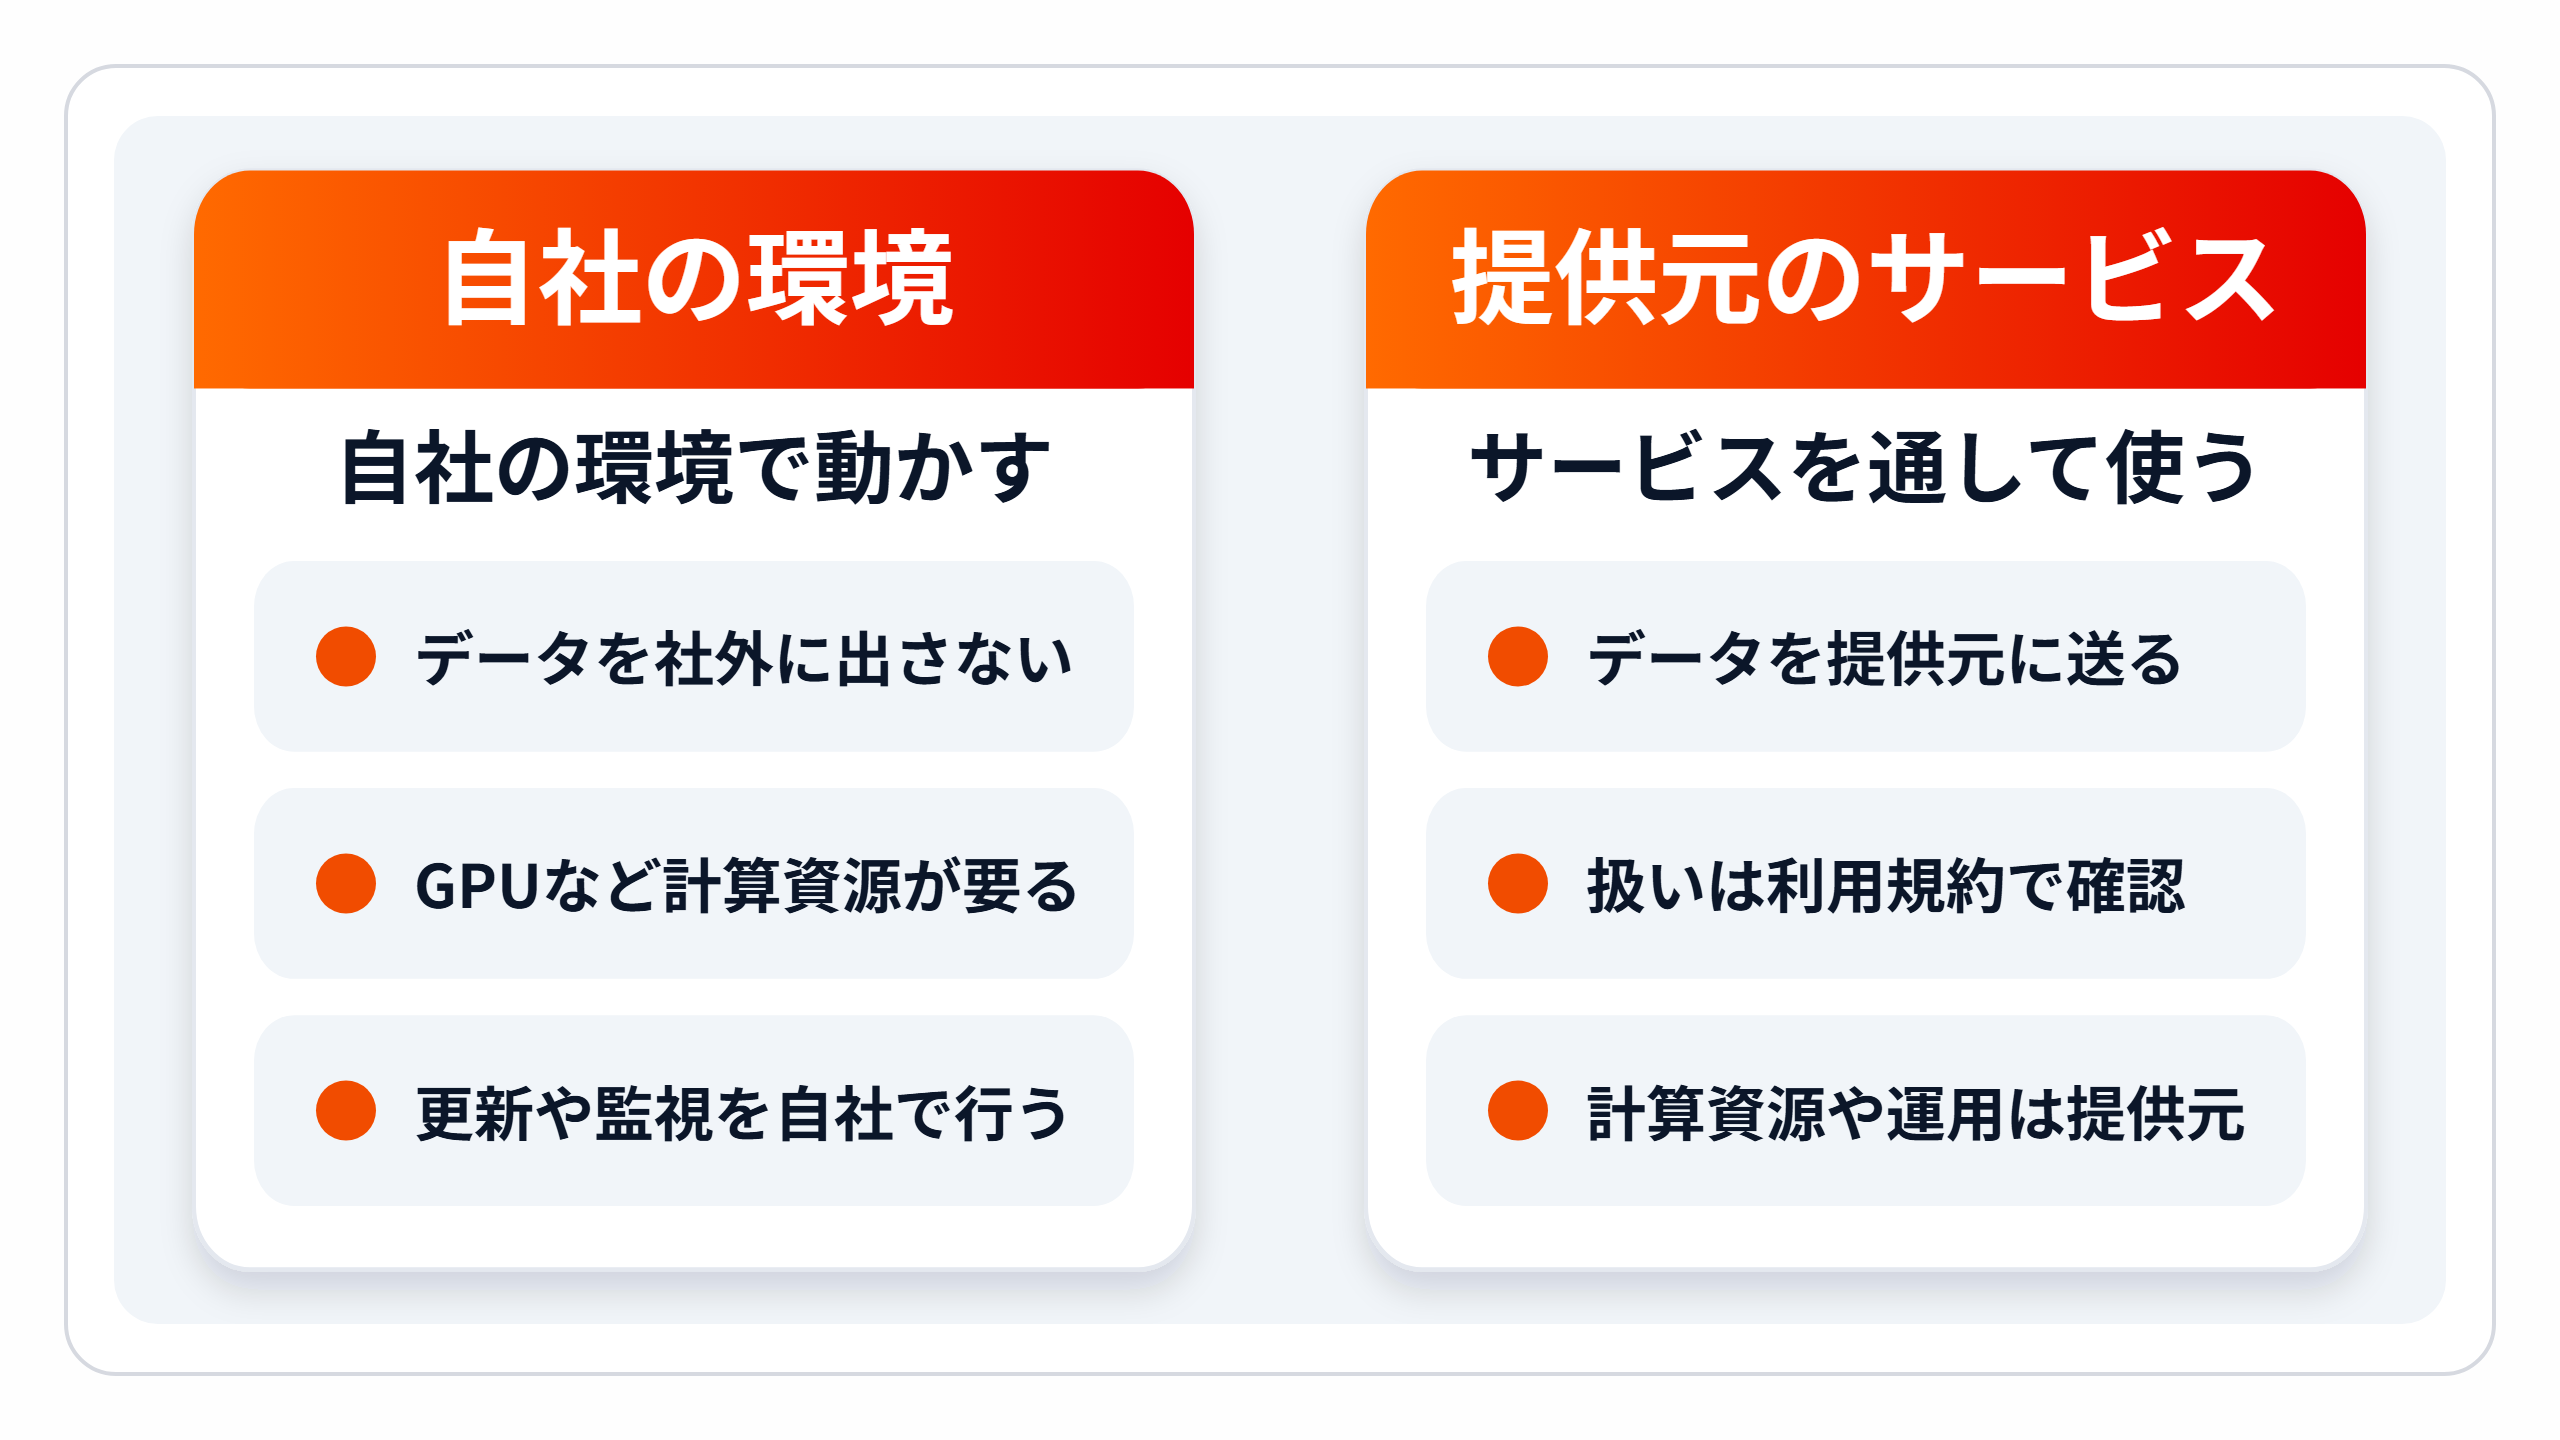
オープンウェイトモデルを業務で使うときは、ライセンス・動かす環境・データの扱いの3点を先に確かめます。モデルの性能だけで選ぶと、使い始めてから条件が合わないと分かることがあるためです。
ライセンスの条件:商用利用できるか、利用者の数などの条件があるか、作者名やライセンスの表示が求められるかを確かめます。条件はモデルごとに違います。
動かす環境:自社のサーバーやクラウドで動かすなら、モデルに合ったGPUなどの計算資源をそろえるほか、動かしたあとの更新や監視も自分たちで行います。
データの扱い:自社の環境で動かせば、入力したデータをモデルの提供元に送らずに使えます。提供元のサービスを通して使う場合は、入力したデータの扱いを利用規約で確かめます。
どの点を重く見るかは、使う業務と扱うデータによって変わります。社内の機密情報を扱うなら、データの扱いから確かめるのがおすすめです。
会議の記録や社内資料にAIを使うなら『Rimo』
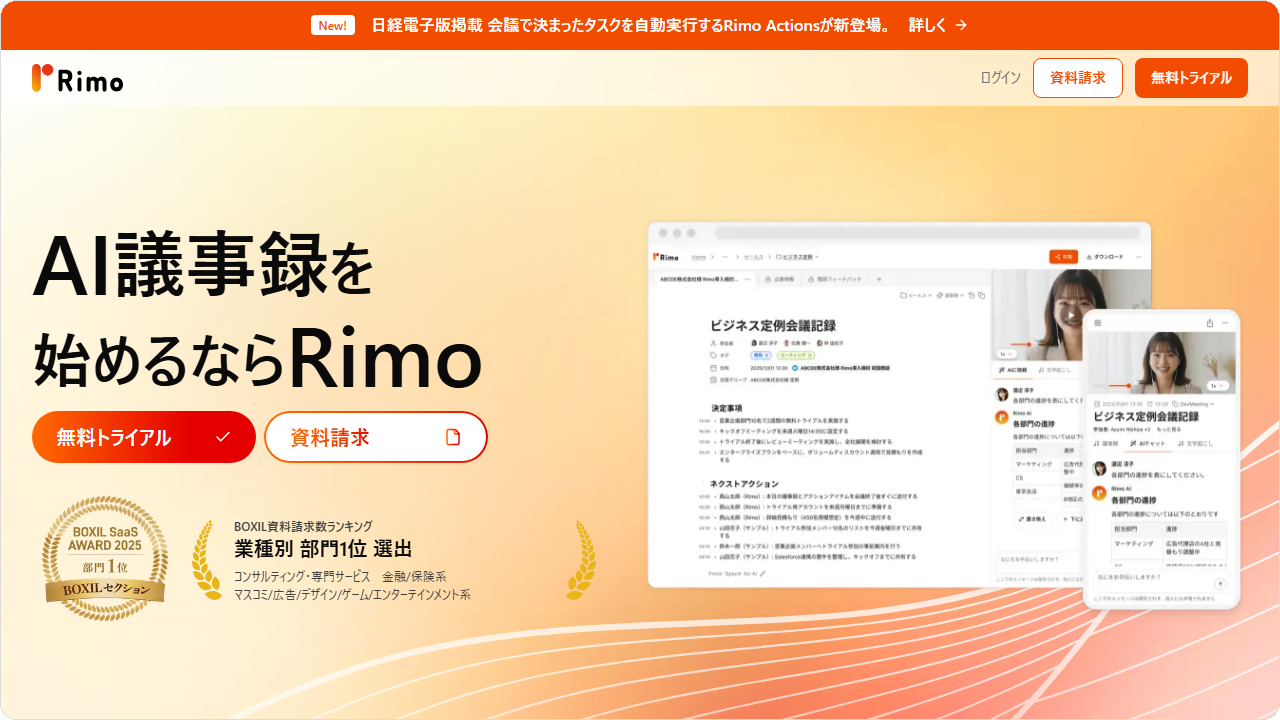
オープンウェイトモデルを自社の環境で動かせば、データをモデルの提供元に送らずにAIを使えます。ただし、会議の録音から議事録を作るには、文字起こしや要約の仕組みを自分たちで組み合わせて整える必要があります。
社内資料をもとに答えるAIを作る場合も同じで、資料の取り込みや検索、見られる人の範囲の設定が要ります。
そうした仕組みを自分たちで整えない場合は、データの扱いを明示しているAIサービスを使うのも現実的な選択肢です。たとえば『Rimo』が示しているのは、次の3点です。
お客様のデータをAIモデルの学習に使わない
日本国内のデータセンターで保管している
ISO/IEC 27001・ISO/IEC 27017の認証を取得している
どれも、社内でAIツールの利用を申請するときに確認されることがある点です。情報システム部門に説明するときの材料にもなります。用途に合わせて、次の2つから選べます。
会議の記録を残すなら、AI議事録サービス『Rimo』
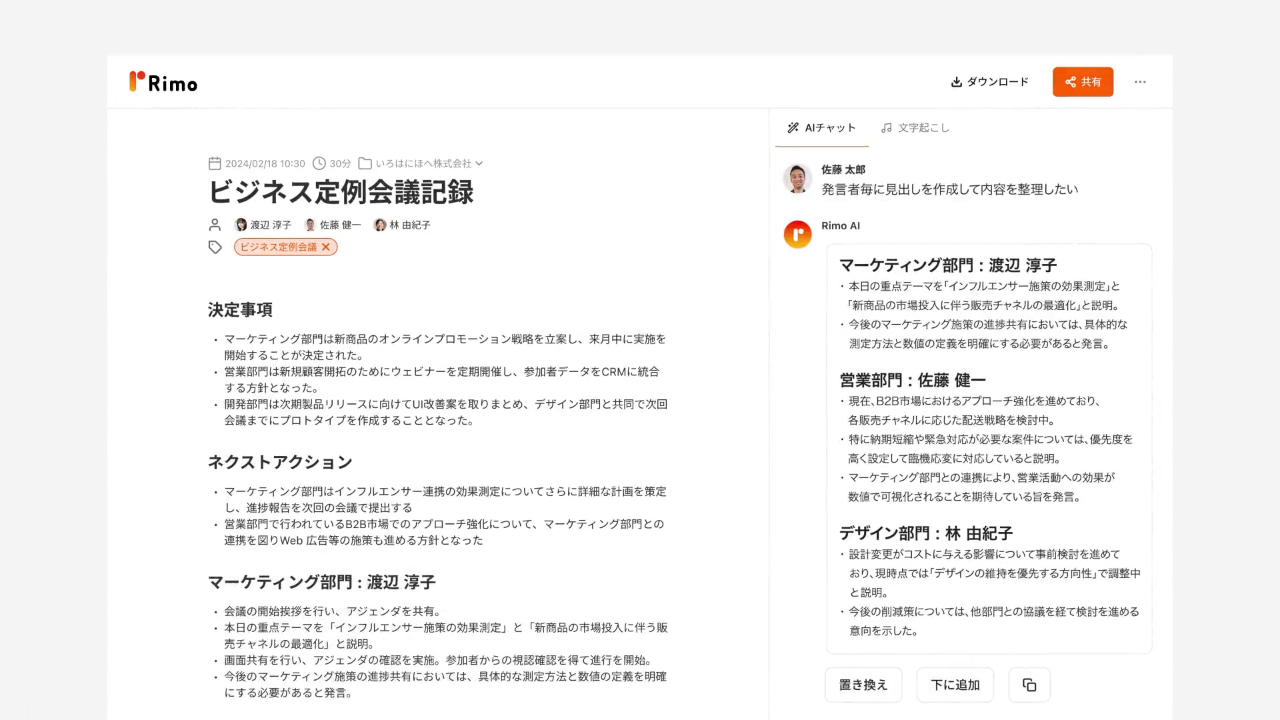
『Rimo』は、会議の録音から文字起こしと議事録を作るAI議事録サービスです。決定事項やネクストアクションをまとめた議事録を残せます。データの扱いは、上の3点のとおりです。
社内資料をもとに答えるAIなら『Rimo ナレッジAI』
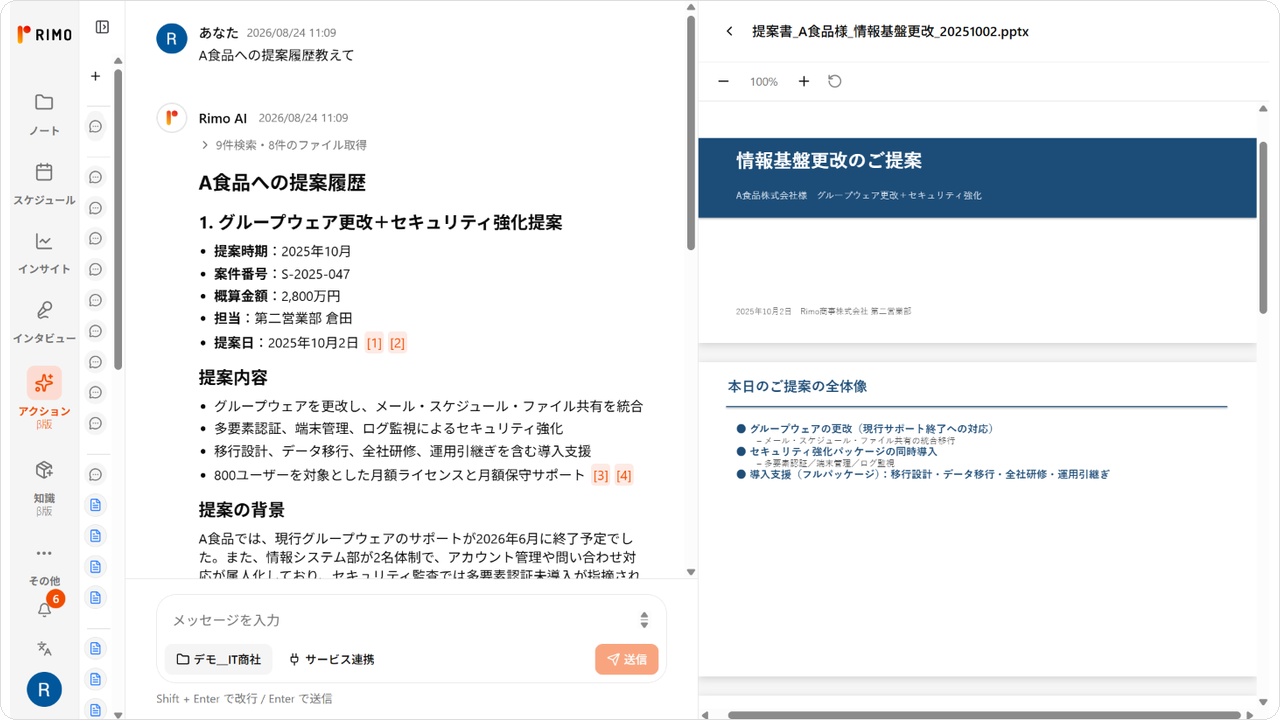
『Rimo ナレッジAI』は、社内資料をもとに質問へ回答する自社専用AIです。
出典付きの回答:取り込んだ社内資料を横断して答え、どの資料をもとにしたかを示します。
既存ツールとの連携:SharePoint・Google Drive・Slack などから情報を取り込めます。
データの扱い:入力データをAIの学習に使いません。権限を持つ社員だけが情報を参照できるアクセス制御にも対応しています。
自社専用のAIを、モデルを自分たちで動かさずに持ちたい場合の選択肢になります。Rimo ナレッジAIのチームプランには、無料トライアルがあります。
オープンウェイトのよくある質問
ここでは、オープンウェイトについてよくある疑問にお答えします。
オープンウェイトとオープンソースの違いは?
いちばんの違いは、公開するものです。オープンウェイトは学習済みのAIモデルとその重みを公開し、オープンソースはソフトウェアのソースコードを公開します。
オープンウェイトモデルは商用利用できる?
商用利用できるモデルはありますが、条件はモデルごとのライセンスによって変わります。
たとえば、Apache 2.0のgpt-oss・Gemma 4や、MIT LicenseのDeepSeek-V4は、商用利用・改変・再配布ができます。
MetaのMuse Spark Openも商用利用できますが、AIモデルを外部に提供する事業で年間売上が2,000万ドルを超える場合は、Metaとの別の契約が必要です。
オープンウェイトモデルを使えば、データを提供元に送らずに済む?
自社の環境で動かせば、入力したデータをモデルの提供元に送らずに使えます。提供元のサービスを通して使う場合は、入力したデータの扱いを利用規約で確かめましょう。
まとめ
オープンウェイトとオープンソースは、公開対象・利用目的・ライセンスが異なります。
オープンウェイトは学習済みのAIモデルを公開し、その利用と応用を広げることが目的です。一方、オープンソースはソフトウェアのソースコードを公開し、その開発と改良が目的です。
オープンウェイトには、AIの利用しやすさ、用途に合わせた作り変え、研究・応用の広がりという利点がある一方で、モデルの信頼性・安全性の確保や倫理的な問題への対応、動かすための計算資源といった課題もあります。
業務でオープンウェイトモデルを使うときは、性能だけでなく、ライセンスの条件やデータの扱いまで確かめることが大切です。
会議の記録や社内資料にAIを使いたい場合は、学習に使わないことや国内での保管を明示している『Rimo』も選択肢の一つとして検討してみてください。
関連記事
タグ
- AI
- DX
一覧に戻る